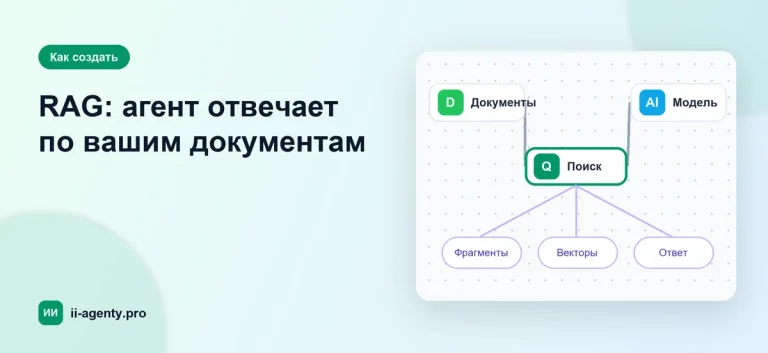
RAG (Retrieval-Augmented Generation, генерация с дополненной выборкой) - способ научить нейросеть отвечать по вашим документам. Перед ответом система находит в базе знаний подходящие фрагменты и передаёт их модели вместе с вопросом. Модель отвечает не "по памяти", а по найденному тексту, поэтому реже выдумывает и может сослаться на источник. Так работают чат-боты поддержки, помощники по внутренним регламентам и агенты, которые знают ассортимент магазина.
Зачем нужен RAG
- Модель не знает ваших данных. Прайс, договоры, инструкции и база клиентов не попадали в её обучение.
- Знания модели устаревают. RAG подставляет актуальную информацию на момент вопроса.
- Документов слишком много. Сотни файлов не поместятся в один запрос, а поиск выбирает только нужные куски.
- Нужны источники. Ответ можно сопроводить ссылкой на документ и раздел, чтобы человек проверил.
Как работает RAG: схема
- Нарезка. Документы делятся на фрагменты (чанки) по 500-1000 знаков с небольшим перекрытием, чтобы мысль не обрывалась на границе.
- Векторизация. Модель эмбеддингов превращает каждый фрагмент в набор чисел (вектор), отражающий смысл текста.
- Хранение. Векторы складываются в векторную базу данных.
- Поиск. Вопрос пользователя тоже превращается в вектор, и база находит фрагменты, близкие по смыслу, даже если слова разные ("вернуть товар" найдёт раздел "Возврат и обмен").
- Ответ. Найденные фрагменты добавляются в промт, и модель отвечает на их основе.
RAG и ИИ-агент
В простом RAG поиск выполняется всегда, перед каждым ответом. В агентном варианте поиск по базе знаний - это один из инструментов агента: агент сам решает, когда искать, может переформулировать запрос и поискать ещё раз, если первая выдача не подошла, или совместить базу знаний с поиском в интернете и CRM. Такой подход точнее на сложных вопросах, но тратит больше запросов к модели.
Из чего собрать RAG-систему
| Компонент | Варианты |
|---|---|
| Модель эмбеддингов | bge-m3 и multilingual-e5 (открытые, хорошо понимают русский, работают локально), эмбеддинги Yandex AI Studio и GigaChat, модели OpenAI |
| Векторная база | Qdrant, PostgreSQL с расширением pgvector, Chroma, Pinecone; для проб - хранилище в памяти |
| Модель для ответа | любая: от облачных до локальных через Ollama |
| Оболочка | n8n без кода, File Search в Yandex AI Studio, библиотеки LangChain и LlamaIndex для программистов |
Как собрать RAG в n8n без кода
- Сценарий загрузки. Триггер (ручной запуск или новая папка в облаке) - узел чтения файлов - узел векторного хранилища в режиме добавления документов. К хранилищу подключите модель эмбеддингов и разделитель текста (Text Splitter) с размером фрагмента около 800 знаков.
- Сценарий ответов. Триггер чата или Telegram - узел AI Agent - к нему как инструмент подключите то же векторное хранилище в режиме поиска, плюс языковую модель и память.
- Системный промт агента:
Ты консультант компании [название]. Отвечай только на основе фрагментов, найденных инструментом поиска по базе знаний. Если ответа в найденных фрагментах нет, честно скажи об этом и предложи связаться с менеджером. В конце ответа укажи название документа-источника.Подробно про сборку агента в n8n - в инструкции ИИ-агент в n8n, а для постоянной работы разверните n8n на своём сервере.
Как повысить точность ответов
- Чистые документы. Уберите дубли и устаревшие версии: агент не знает, какой из двух прайсов актуальный.
- Размер фрагмента. Слишком маленькие куски теряют контекст, слишком большие размывают поиск. Начните с 500-1000 знаков и перекрытия 100-200.
- Метаданные. Сохраняйте у фрагментов название документа, раздел и дату: по ним можно фильтровать и ссылаться.
- Гибридный поиск. Сочетание векторного поиска с поиском по словам лучше находит артикулы, номера и редкие термины.
- Тестовый набор. Составьте 30-50 реальных вопросов с правильными ответами и проверяйте систему на них после каждого изменения.
Частые ошибки
| Проблема | Причина и решение |
|---|---|
| Агент выдумывает | нет запрета отвечать без источника в промте, или поиск ничего не нашёл; добавьте правило "не знаю - так и скажи" |
| Находит не те куски | модель эмбеддингов плохо понимает русский; возьмите многоязычную, например bge-m3 |
| Таблицы читаются плохо | при нарезке таблицы разрываются; храните таблицы отдельно или переводите строки в текст "товар - цена - наличие" |
| Ответы устаревают | база не обновляется; настройте сценарий переиндексации по расписанию |
Частые вопросы
RAG или дообучение модели?
Для знаний (факты, документы, цены) почти всегда RAG: он дешевле, обновляется за минуты и показывает источники. Дообучение нужно, чтобы изменить стиль и формат ответов, а не чтобы модель запомнила документы.
Можно ли сделать RAG полностью локально?
Да: модель эмбеддингов bge-m3 и языковая модель в Ollama, база Qdrant в Docker, оболочка n8n. Данные не покидают ваш сервер.
Сколько документов можно загрузить?
Векторные базы спокойно работают с миллионами фрагментов. Ограничение обычно в качестве документов и стоимости эмбеддингов, а не в объёме.